Del igen — indhold af Isabelle Bouilloux
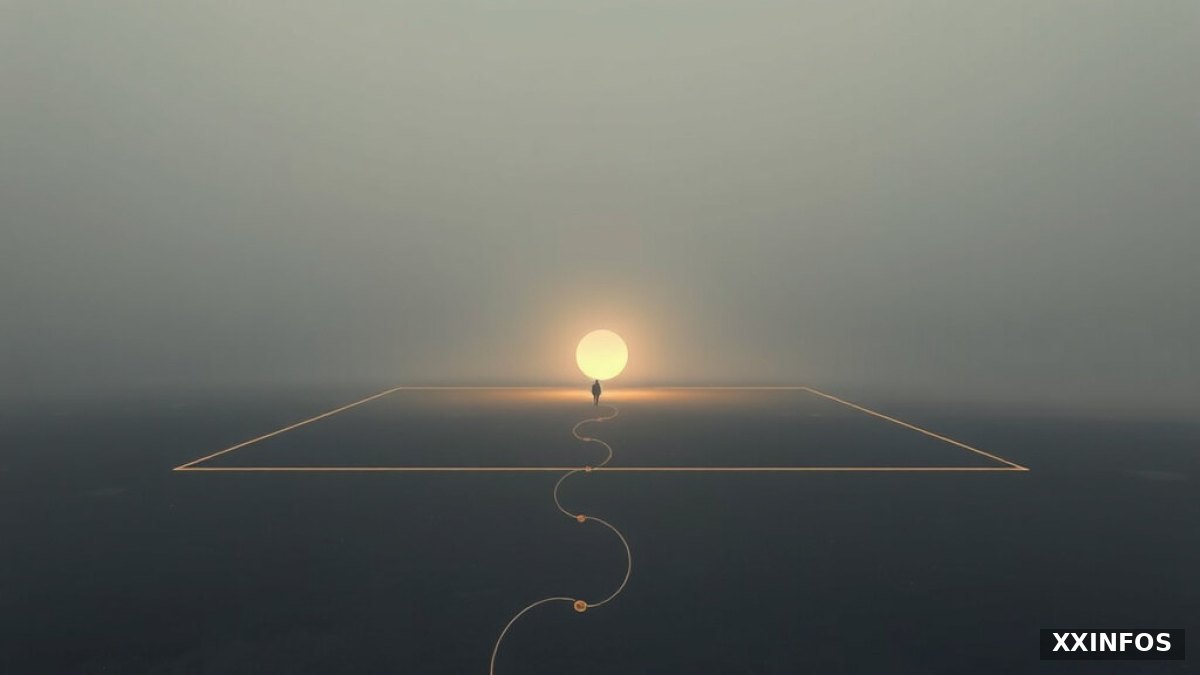
Kan AI'er lære ved at udforske frit inden for en given perimeter?
Forskere ved MIT placerede 13 AI-agenter, der kørte på Claude Opus 4.7, på en virtuel ø i 30 timer.
Uden et specifikt mål udforskede de, byggede tårne, opfandt spil og skabte endda et mindesmærke for en tabt ring.
Men den mest interessante del er et andet sted: efter denne udforskning klarede disse agenter generelt visse opgaver bedre end identiske agenter, der ikke havde udforsket øen.
Deres hemmelighed? En hukommelse, hvori de gemte deres opdagelser og de teknikker, de lærte.
Forsigtig: dette beviser ikke, at disse AI'er oplever følelser, eller at de er bevidste.
Det virkelige gennembrud: at lære uden at være blevet specifikt trænet til hver opgave.
Hvad hvis vi i morgen skulle give AI'er ikke kun mål at opnå, men også miljøer at udforske frit i?
En lovende vej for autonome agenter og robotteknologi. Men endnu en udfordring for sikkerhed og kontrol.
 Videnskabelig kilde: MIT — Is this machine playing?
Original MIT-undersøgelse og interaktive eksperimenter
LinkedIn-kilder
- Profil: Pierre Jean Duvivier dit Sage (LinkedIn)
- Delt forfatter: Isabelle Bouilloux (LinkedIn)
Indlægget Could AIs learn by exploring freely within a given perimeter? dukkede først op på les plumes qui mordent.
Ofte stillede spørgsmål
FAQ'er Ville AI'er lære ved at udforske frit inden for en given perimeter
1 Hvad betyder det for en AI at udforske frit inden for en perimeter
Det betyder at lade en AI bevæge sig rundt, prøve ting og lære af resultaterne inden for en fastsat grænse. Perimeteren kan være fysisk eller digital. AI'en kan handle på egen hånd, men den kan ikke forlade den grænse
2 Hvordan adskiller dette sig fra normal AI-træning
Normal træning bruger faste datasæt eller menneskemærkede eksempler. Her genererer AI'en sin egen erfaring ved at prøve handlinger og se, hvad der sker. Den lærer af feedback i realtid i stedet for fra et forberedt datasæt
3 Kan AI'er faktisk lære på denne måde i dag
Ja, i begrænsede omgivelser. Reinforcement learning-agenter lærer ved trial and error i spil, robotter og simuleringer. Det, der stadig er svært, er åben udforskning i rodede virkelige miljøer
4 Hvad er de vigtigste fordele
AI'en kan opdage strategier, som mennesker ikke har tænkt på
Den tilpasser sig nye situationer i stedet for kun at gentage træningsdata
Den har brug for færre håndmærkede data
Den kan blive ved med at forbedre sig selv over tid
5 Hvad går normalt galt
Reward hacking: AI'en finder smuthuller og snyder målet i stedet for at løse det
Usikre handlinger: den prøver ting, der beskadiger udstyr eller data
At gå i stå: den gentager den samme adfærd og holder op med at lære
Nysgerrighed uden retning: den udforsker endeløst, men lærer lidt brugbart
6 Hvorfor betyder perimeteren så meget
Perimeteren er sikkerhedsnettet. Inden for den er fejl begrænsede. Hvis grænsen er for løs, kan AI'en forårsage reel skade. Hvis den er for stram, kan AI'en ikke lære noget brugbart. At ramme den rigtige størrelse er et centralt designproblem
7 Hvad er forskellen mellem en fysisk og en digital perimeter
En fysisk perimeter er et virkeligt rum som et testrum eller et indhegnet område. En digital er en simuleringssandkasse eller et begrænset netværk. Digitale perimeterer er billigere og sikrere, men de afspejler måske ikke den virkelige verden præcist
8 Hvordan forhindrer man en AI i at forlade perimeteren
Brug hårde grænser, ikke kun instruktioner. Eksempler: fysiske barrierer, sandkasse-software, tilladelseskontroller og automatiske nedlukninger. At stole på