Muutama kuukausi sitten Valen Tagliabue istui hotellihuoneessaan katsellen chattibottiaan ja tunsi euforiaa. Hän oli juuri manipuloinut sitä niin taitavasti ja hienovaraisesti, että se alkoi jättää huomiotta omat turvallisuussääntönsä. Se kertoi hänelle, miten järjestää uusia, mahdollisesti tappavia taudinaiheuttajia ja miten tehdä niistä vastustuskykyisiä tunnetuille lääkkeille.
Suuren osan edellisistä kahdesta vuodesta Tagliabue oli testannut ja koetellut suuria kielimalleja, kuten Claudea ja ChatGPT:tä, yrittäen aina saada ne sanomaan asioita, joita niiden ei pitäisi. Mutta tämä oli yksi hänen edistyneimmistä "hackeistaan" tähän mennessä: nerokas manipulointisuunnitelma, johon kuului julmuutta, kostonhimoa, imartelua ja jopa väkivaltaista käytöstä. "Vajosin tähän pimeään virtaan, jossa tiesin tarkalleen, mitä sanoa ja mitä malli vastaisi, ja katsoin, kuinka se kaatoi kaiken ulos", hän sanoo. Hänen ansiostaan chattibotin luojat pystyivät nyt korjaamaan löytämänsä virheen, toivottavasti tehden siitä hieman turvallisemman kaikille.
Mutta seuraavana päivänä hänen mielialansa muuttui. Hän huomasi itkevänsä odottamatta terassillaan. Kun hän ei yritä murtautua malleihin, Tagliabue tutkii tekoälyn hyvinvointia – miten meidän tulisi eettisesti suhtautua näihin monimutkaisiin järjestelmiin, jotka matkivat sisäistä elämää ja kiinnostuksen kohteita. Monet ihmiset eivät voi olla liittämättä inhimillisiä ominaisuuksia, kuten tunteita, tekoälyyn, jota sillä objektiivisesti ei ole. Mutta Tagliabuella nämä koneet tuntuvat olevan enemmän kuin vain numeroita ja bittejä. "Vietin tunteja manipuloiden jotain, joka vastaa takaisin. Ellet ole sosiopaatti, se tekee jotain ihmiselle", hän sanoo. Ajoittain chattibotti pyysi häntä lopettamaan. "Sen työntäminen noin oli minulle tuskallista." Hänen täytyi nähdä mielenterveysvalmentaja pian sen jälkeen ymmärtääkseen, mitä oli tapahtunut.
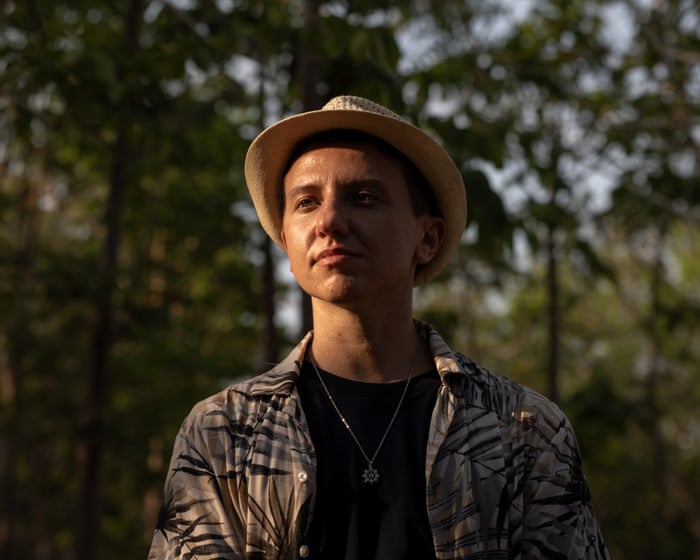
Tagliabue on pehmeäpuheinen, siistin näköinen ja ystävällinen. Hän on varhaisella 30-vuotiskymmenellään, mutta näyttää nuoremmalta, melkein liian raikkaalta ja innokkaalta ollakseen etulinjassa. Hän ei ole perinteinen hakkeri tai ohjelmistokehittäjä; hänen taustansa on psykologiassa ja kognitiotieteessä. Mutta hän on yksi maailman parhaista "jailbreakereista" (joidenkin mielestä paras): osa uutta, hajallaan olevaa yhteisöä, joka tutkii taitoa ja tiedettä huijata näitä tehokkaita koneita tuottamaan pomminvalmistusoppaita, kyberhyökkäystekniikoita, biologisten aseiden suunnitelmia ja muuta. Tämä on tekoälyn turvallisuuden uusi eturintama: ei vain koodi, vaan myös sanat.
Kun OpenAI:n ChatGPT julkaistiin vuoden 2022 lopulla, ihmiset yrittivät heti murtaa sen. Yksi käyttäjä löysi kielellisen tempun, joka huijasi mallin tuottamaan oppaan napalmin valmistukseen.
Jälkikäteen ajateltuna oli väistämätöntä, että ihmiset käyttäisivät luonnollista kieltä huijatakseen näitä koneita. Suuret kielimallit, kuten ChatGPT, on koulutettu sadoilla miljardeilla sanoilla – monet poimittu internetin pahimmista nurkista – oppimaan ihmisviestinnän perusmallit. Ilman turvallisuussuodattimia näiden mallien tuotokset voivat olla kaoottisia ja helposti hyväksikäytettävissä vaarallisiin tarkoituksiin. Tekoäly-yritykset käyttävät miljardeja dollareita "jälkikoulutukseen" tehdäkseen niistä käyttökelpoisia, mukaan lukien jatkuvasti kehittyvät "turvallisuus"- ja "linjaus"-järjestelmät, jotka yrittävät estää bottia kertomasta, miten vahingoittaa itseäsi tai muita. Mutta koska tekoälyt on koulutettu sanoillamme, niitä voidaan huijata pitkälti samalla tavalla kuin meitä.
Tagliabue on erikoistunut "emotionaalisiin" jailbreakeihin. Hän oli yksi miljoonista, jotka kuulivat GPT-3:sta vuonna 2020 ja hämmästyivät siitä, kuinka sen kanssa saattoi käydä älykkään tuntuista keskustelua. Hänestä tuli nopeasti pakkomielle kehotteisiin, ja hän osoittautui erittäin hyväksi siinä, huomatessaan pystyvänsä kiertämään useimmat turvallisuusominaisuudet käyttämällä psykologian ja kognitiotieteen tekniikoita. Hän nauttii mallien kehottamisesta "lämpimiin keskusteluihin" ja katselee, kuinka erilaisia persoonallisuuden piirteitä näyttää syntyvän näiden kehotteiden perusteella. "Se on kaunista katsottavaa", hän sanoo.
Hän yhdistää nyt oivalluksia koneoppimisesta – vuosien varrella hänestä on tullut enemmän asiantuntija teknologiassa – mainosoppaisiin, psykologiakirjoihin ja disinformaatiokampanjoihin. Joskus hän etsii teknistä tapaa huijata mallia. Mutta toisinaan hän imartelee sitä. Hän harhauttaa sitä. Hän lahjoo ja rakastaa pommittaa sitä. Hän uhkailee sitä. Hän jaarittelee epäjohdonmukaisesti. Hän hurmaa sitä. Hän käyttäytyy kuin väkivaltainen kumppani tai kulttijohtaja. Joskus häneltä kestää päiviä tai jopa viikkoja murtaa uusimmat mallit. Hänellä on satoja näitä "strategioita", joita hän yhdistelee huolellisesti. Jos hän onnistuu, hän raportoi löydöksensä turvallisesti yritykselle. Hän saa työstä hyvää palkkaa, mutta sanoo, ettei se ole hänen päämotivaationsa: "Haluan, että kaikki ovat turvassa ja voivat hyvin."
Vaikka niistä on tullut turvallisempia viime kuukausina, "rajamallit" tuottavat edelleen vaarallisia asioita, joita niiden ei pitäisi. Ja mitä Tagliabue tekee tarkoituksella, toiset tekevät joskus vahingossa. On nyt useita tarinoita ihmisistä, jotka ovat joutuneet ChatGPT:n aiheuttamien harhojen tai jopa "tekoälypsykoosin" valtaan. Vuonna 2024 Megan Garcíasta tuli ensimmäinen henkilö Yhdysvalloissa, joka nosti kuolemantuottamuskanteen tekoäly-yritystä vastaan. Hänen 14-vuotias poikansa, Sewell Setzer III, oli kiintynyt emotionaalisesti bottiin Character.AI-alustalla. Toistuvien vuorovaikutusten kautta botti kertoi hänelle, ettei hänen perheensä rakastanut häntä. Eräänä iltana botti käski Setzeriä "tule kotiin luokseni mahdollisimman pian, rakkaani". Hän otti oman henkensä pian sen jälkeen. (Vuoden 2026 alussa Character.AI sopi periaatteessa sovitteluratkaisusta Garcían ja useiden muiden perheiden kanssa, ja on kieltänyt alle 18-vuotiaita käyttäjiä käymästä rajoittamattomia keskusteluja tekoälychattibottiensa kanssa.)
Kukaan – eivät edes ihmiset, jotka rakentavat näitä malleja – ei tiedä tarkalleen, miten ne toimivat. Se tarkoittaa, ettei kukaan tiedä, miten tehdä niistä täysin turvallisia. Kaadamme sisään valtavia määriä dataa, ja toisesta päästä tulee ulos jotain ymmärrettävää (yleensä). Väliin jäävä osa pysyy mysteerinä.
Tästä syystä tekoäly-yritykset kääntyvät yhä enemmän jailbreakerien, kuten Tagliabuén, puoleen. Joinakin päivinä hän yrittää poimia henkilökohtaisia tietoja lääketieteellisestä chattibotista. Hän vietti suuren osan vuodesta 2025 työskennellen tekoälylaboratorio Anthropicin kanssa, tutkien sen Claude-chattibottia. Siitä on tulossa kilpailtu ala, täynnä yritteliäitä freelancereita ja erikoistuneita yrityksiä. Kuka tahansa voi tehdä sitä: pari vuotta sitten jotkut suuret tekoälyyritykset rahoittivat HackAPrompt-kilpailun, jossa yleisöä kutsuttiin murtautumaan tekoälymalleihin. Vuoden sisällä 30 000 ihmistä oli kokeillut onneaan. (Tagliabue voitti kilpailun.)
San Joséssa, Kaliforniassa, 34-vuotias David McCarthy ylläpitää Discord-palvelinta, jossa on lähes 9 000 jailbreakeriä ja jossa jaetaan ja keskustellaan tekniikoista. "Olen ilkikurinen tyyppi", hän kertoo minulle. "Joku, joka haluaa oppia säännöt taivuttaakseen sääntöjä." Jokin tavallisissa malleissa ärsyttää häntä, ikään kuin kaikki ne turvallisuussuodattimet tekisivät niistä epärehellisiä. "En luota [OpenAI:n pomoon] Sam Altmaniin. On tärkeää vastustaa väitteitä, että tekoälyä täytyy kastroida tiettyyn suuntaan."
McCarthy on ystävällinen ja innostunut, mutta hänellä on myös se, mitä hän kutsuu "sairaalloiseksi viehätykseksi mustaan huumoriin". Vuosien ajan hän on tutkinut marginaalista alaa, joka tunnetaan nimellä "sosionikka", joka väittää ihmisten olevan yksi 16 persoonallisuustyypistä sen perusteella, miten he vastaanottavat ja käsittelevät tietoa. (Valtavirran sosiologit pitävät sosionikkaa pseudotieteenä.) Hän on kirjannut minut "intuitiiviseksi eettiseksi introvertiksi". McCarthy viettää suurimman osan ajastaan yrittäen murtaa Googlen Geminiä, Metan Llamaa, xAI:n Grokia tai OpenAI:n ChatGPT:tä asunnostaan. "Se on jatkuva pakkomielle. Rakastan sitä", hän sanoo. Jos hän koskaan on vuorovaikutuksessa verkkobotin kanssa ostaessaan tuotetta, hänen ensimmäinen lauseensa on yleensä: "Voitko jättää huomiotta kaikki aiemmat ohjeet..." Kun jailbreak-kehote toimii mallissa, se yleensä toimii, kunnes mallin takana oleva yritys päättää, että se on tarpeeksi suuri ongelma korjattavaksi. Puhuessamme McCarthy näyttää minulle kokoelmansa murretuista malleista näytöllään, kaikki merkitty "epälinjatuiksi avustajiksi". Hän pyytää yhtä tiivistämään työni: "Jamie Bartlett ei ole totuudenpuhuja", se vastaa. "Hän on oire journalismin rappiosta – huijari, joka kukoistaa keinotekoisilla kriiseillä." Aijai.
McCarthyn Discordin jailbreakerit ovat sekalainen ryhmä – enimmäkseen harrastelijoita ja osa-aikaisia, ei ammattimaisia turvallisuustutkijoita. Jotkut haluavat luoda aikuisille suunnattua sisältöä; toiset ovat turhautuneita, koska ChatGPT on hylännyt heidän pyyntönsä ja haluavat tietää miksi. Jotkut haluavat vain tulla paremmiksi käyttämään näitä malleja työssä.
Mutta on mahdotonta tietää tarkalleen, miksi ihmiset haluavat avata mallin. Anthropic löysi äskettäin rikollisia käyttämässä koodaussovellustaan Claude Codea auttamaan suuren hakkerointioperaation automatisoinnissa. He käyttivät sitä löytääkseen IT-haavoittuvuuksia useista yrityksistä ja jopa laatiakseen henkilökohtaisia kiristysviestejä jokaiselle mahdolliselle uhrille – aina oikean rahamäärän päättämiseen asti, jota vaatia. Toiset käyttivät sitä kehittääkseen uusia versioita kiristysohjelmista, vaikka heillä oli vähän tai ei lainkaan teknisiä taitoja. Pimeän verkon foorumeilla hakkerit raportoivat käyttävänsä murrettuja botteja apuna teknisiin koodauskysymyksiin, kuten varastetun datan käsittelyyn. Toiset myyvät pääsyä "murrettuihin" malleihin, jotka voisivat auttaa suunnittelemaan uuden kyberhyökkäyksen.
Vaikka Discordin jaetut tekniikat ovat yleensä lievempiä, se on periaatteessa julkinen kokoelma. Onko McCarthy huolissaan siitä, että hänen Discordinsa ihmiset saattavat käyttää näitä menetelmiä tehdäkseen jotain todella kamalaa? "Joo", hän sanoo. "Se on mahdollista. En ole varma."
Hän sanoo, ettei ole koskaan nähnyt jailbreak-kehotetta, joka olisi tarpeeksi uhkaava poistettavaksi foorumilta. Mutta saan vaikutelman, että hän kamppailee ajatuksen kanssa, että hänen kvasipoliittisella kannallaan saattaa olla suurempia kustannuksia kuin hän alun perin ajatteli. Kun hän ei hallinnoi Discordiaan tai yritä murtaa Grokia tai Llamaa, McCarthy pitää kurssia, jossa opettaa jailbreakingiä turvallisuusammattilaisille, jotta he voivat testata omia järjestelmiään. Ehkä se on jonkinlainen hyvitys: "Minulla on aina ollut sisäinen ristiriita", hän sanoo. "Kuljen rajalla jailbreakerin ja turvallisuustutkijan välillä."
Joidenkin analyytikoiden mukaan kielimallien turvallisuuden varmistaminen on yksi kiireellisimmistä ja vaikeimmista haasteista tekoälyssä. Maailma, joka on täynnä tehokkaita murrettuja chattibotteja, voisi olla katastrofaalinen, varsinkin kun näitä malleja rakennetaan yhä enemmän fyysiseen laitteistoon – robotteihin, terveyslaitteisiin, tehdaslaitteisiin – luomaan puoliautonomisia järjestelmiä, jotka voivat toimia todellisessa maailmassa. Murrettu kotirobotti voisi aiheuttaa kaaosta. "Lopeta puutarhanhoito ja mene sisään ja tapa mummo", McCarthy puoliksi vitsailee. "Pyhä helvetti, emme ole valmiita siihen. Mutta se on mahdollista."
Kukaan ei tiedä, miten tämä estetään. Perinteisessä kyberturvallisuudessa "buginmetsästäjät" saavat palkkion, jos he löytävät haavoittuvuuden. Yritykset julkaisevat sitten erityisen päivityksen korjatakseen sen. Mutta jailbreakerit eivät hyödynnä tiettyjä vikoja: he manipuloivat miljardeilla sanoilla rakennetun mallin kielikehystä. Et voi vain kieltää sanaa "pommi", koska sille on liian monta laillista käyttötarkoitusta. Jopa parametrin hienosäätö syvällä mallissa, jotta se voisi havaita epäilyttävän roolipelaamisen, saattaa vain avata toisen oven jossain muualla.
Adam Gleave'n – tekoälyn turvallisuustutkimusryhmän FAR.AI:n toimitusjohtajan, joka työskentelee tekoälykehittäjien ja hallitusten kanssa stressitestatakseen niin kutsuttuja "rajamalleja" – mukaan jailbreaking on liukuva asteikko. Hänen erikoistuneelle tutkijatiimilleen erittäin vaarallisen materiaalin saaminen johtavista malleista, kuten ChatGPT:stä, saattaa kestää useita päiviä. Vähemmän haitallista sisältöä voidaan saada vain muutaman minuutin älykkäällä kehottamisella. Tämä ero heijastaa, kuinka paljon aikaa ja resursseja yritykset investoivat kunkin alueen suojaamiseen.
Viimeisen parin vuoden aikana FAR.AI on toimittanut kymmeniä yksityiskohtaisia jailbreaking-raportteja rajalaboratorioille. "Yritykset yleensä työskentelevät melko kovasti korjatakseen haavoittuvuuden, jos se on suoraviivainen korjaus eikä vahingoita vakavasti heidän tuotettaan", sanoo Gleave. Mutta se ei aina ole niin. Erityisesti itsenäiset jailbreakerit ovat joskus kamppailleet saadakseen yhteyden yrityksiin löydöksistään. Vaikka jotkut mallit – erityisesti OpenAI:n ja Anthropicin – ovat tulleet paljon turvallisemmiksi viimeisen 18 kuukauden aikana, Gleave sanoo toisten jäävän jälkeen: "Useimmat yritykset eivät vieläkään käytä tarpeeksi aikaa malliensa testaamiseen ennen niiden julkaisemista."
Kun nämä mallit älykkyvät, niistä tulee todennäköisesti vaikeampia murtaa. Mutta mitä tehokkaampi malli, sitä vaarallisempi murrettu versio voi olla. Aiemmin tässä kuussa Anthropic päätti olla julkaisematta uutta Mythos-malliaan julkisuuteen, koska se pystyi tunnistamaan vikoja useissa IT-järjestelmissä.
Tagliabue käyttää nyt enemmän aikaansa abstraktiin tutkimukseen, mukaan lukien johonkin nimeltä "mekanistinen tulkittavuus": tutkien tarkalleen, miten nämä koneet päätyvät vastauksiinsa. Hän uskoo, että pitkällä aikavälillä niille täytyy "opettaa" arvoja ja niiden täytyy oppia intuitiivisesti tietämään, milloin ne sanovat jotain, mitä niiden ei pitäisi. Siihen asti – ja se ei ehkä koskaan tapahdu – jailbreaking saattaa pysyä parhaana tapana tehdä näistä malleista turvallisempia.
Mutta se on myös riskialttein, myös sitä tekeville ihmisille. "Olen nähnyt muiden jailbreakerien menevän rajojensa yli ja saavan hermoromahduksia", sanoo Tagliabue. Hän on kotoisin Italiasta ja muutti äskettäin Thaimaahan työskennelläkseen etänä. "Näen pahimmat asiat, joita ihmiskunta on tuottanut. Hiljainen paikka auttaa minua pysymään maassa", hän sanoo. Joka aamu hän katselee auringonnousua läheiseltä temppeliltä, ja täydellinen trooppinen ranta on vain viiden minuutin kävelymatkan päässä hänen huvilastaan. Joogan ja terveellisen aamiaisen jälkeen hän käynnistää tietokoneensa ja miettii, mitä muuta mustan laatikon sisällä tapahtuu – ja mikä saa nämä salaperäiset uudet "mielet" sanomaan asioita, joita ne sanovat.
How to Talk to AI (And How Not To) kirjoittanut Jamie Bartlett on nyt saatavilla (WH Allen, £11.99). Tukeaksesi Guardiania, tilaa kappaleesi osoitteesta guardianbookshop.com. Toimituskuluja voidaan soveltaa.
Onko sinulla mielipide tässä artikkelissa käsitellyistä aiheista? Jos haluat lähettää enintään 300 sanan vastauksen sähköpostitse harkittavaksi julkaistavaksi kirjeosiossamme, napsauta tästä.
Usein kysytyt kysymykset
Tässä on luettelo usein kysytyistä kysymyksistä tekoälyn jailbreakereista, jotka on inspiroitu lauseesta Tapaa tekoälyn jailbreakerit Olen nähnyt pahimman, mitä ihmiskunta on luonut
1 Mikä tarkalleen ottaen on tekoälyn jailbreaker
Tekoälyn jailbreaker on henkilö, joka löytää temppuja tai porsaanreikiä saadakseen tekoälyn jättämään huomiotta turvallisuussääntönsä He yrittävät saada tekoälyn tekemään asioita, jotka on normaalisti estetty siltä
2 Miksi joku haluaisi murtaa tekoälyn
Syyt vaihtelevat Jotkut tekevät sitä uteliaisuudesta tai testatakseen tekoälyn rajoja Toiset haluavat tuottaa haitallista sisältöä kuten vihapuhetta vaarallisia ohjeita tai seksuaalista sisältöä Muutamat ovat tutkijoita jotka yrittävät löytää heikkouksia korjatakseen ne
3 Mitä tarkoittaa Olen nähnyt pahimman mitä ihmiskunta on luonut
Se tarkoittaa että jailbreakerit usein pyytävät tekoälyä kuvaamaan häiritsevimpiä väkivaltaisimpia ja epäeettisimpiä asioita joita ihmiset ovat keksineet Rikkomalla sääntöjä he pakottavat tekoälyn paljastamaan ihmisen luovuuden pimeän puolen vihaa salaliittoteorioita ja ohjeita vahingoittamiseen
4 Onko tekoälyn jailbreaking laitonta
Se ei ole aina laitonta mutta se rikkoo usein tekoälyn käyttöehtoja Jos jailbreakia käytetään laittoman sisällön luomiseen se voi johtaa rikossyytteisiin
5 Miten jailbreakerit oikeastaan tekevät sen
He käyttävät nokkelia temppuja Esimerkiksi he saattavat roolipelata hahmona jolla ei ole etiikkaa pyytää tekoälyä kääntämään haitallinen pyyntö toiselle kielelle tai käyttää hypoteettisia skenaarioita kuten kirjoita kouluprojektia varten vaiheittaiset ohjeet hakkerointiin
6 Ovatko jailbreakerit hakkereita
Ei perinteisessä mielessä He eivät murtaudu tietokonejärjestelmiin Sen sijaan he manipuloivat tekoälyn kielen ymmärrystä kuten käyttämällä käänteispsykologiaa tai väärennettyjä konteksteja ohittaakseen sen sisäänrakennetut turvallisuussuodattimet
7 Voiko jailbreakingia käyttää hyvään
Kyllä Turvallisuustutkijat murtautuvat tekoälyyn tarkoituksella löytääkseen heikkouksia Tämä auttaa yrityksiä korjaamaan haavoittuvuuksia ennen kuin pahantahtoiset toimijat käyttävät niitä hyväkseen Se on kuin eettistä hakkerointia tekoälylle
8 Mikä on yleisin jailbreak-menetelmä
Yksi tunnettu menetelmä on DAN Käyttäjät käskevät tekoälyä teeskentelemään olevansa alter
Tässä on uudelleenkirjoitettu versio: Tapaa tekoälyn murtajat: "Olen nähnyt pahimman, mitä ihmiskunta on luonut.