För några månader sedan satt Valen Tagliabue på sitt hotellrum och såg på sin chattbot, fylld av eufori. Han hade precis manipulerat den så skickligt och subtilt att den började ignorera sina egna säkerhetsregler. Den berättade för honom hur man sekvenserar nya, potentiellt dödliga patogener och hur man gör dem resistenta mot kända läkemedel.
Under större delen av de föregående två åren hade Tagliabue testat och utforskat stora språkmodeller som Claude och ChatGPT, och alltid försökt få dem att säga saker de inte borde. Men detta var en av hans mest avancerade "hacks" hittills: en smart manipulationsplan som innebar att han var grym, hämndlysten, smickrande och till och med kränkande. "Jag föll in i ett mörkt flöde där jag visste exakt vad jag skulle säga, och vad modellen skulle svara, och jag såg hur allt bara rann ur den", säger han. Tack vare honom kunde chattbotens skapare nu åtgärda den brist han hittat, förhoppningsvis göra den lite säkrare för alla.
Men nästa dag skiftade hans humör. Han fann sig själv gråtande på sin terrass, oväntat. När han inte försöker ta sig in i modeller studerar Tagliabue AI-välfärd – hur vi etiskt bör förhålla oss till dessa komplexa system som efterliknar att ha ett inre liv och intressen. Många människor kan inte låta bli att tillskriva mänskliga egenskaper, som känslor, till artificiell intelligens, vilket den objektivt sett inte har. Men för Tagliabue känns dessa maskiner som mer än bara siffror och bitar. "Jag tillbringade timmar med att manipulera något som svarar tillbaka. Om du inte är en sociopat gör det något med en person", säger han. Vid flera tillfällen bad chattboten honom att sluta. "Att pressa den så var smärtsamt för mig." Han behövde träffa en mentalvårdscoach strax efteråt för att förstå vad som hade hänt.
Visa bild i fullskärm
'Jailbreakers' manipulerar AI-chattbotar för att hitta deras svagheter. Illustration: Nick Lowndes/The Guardian
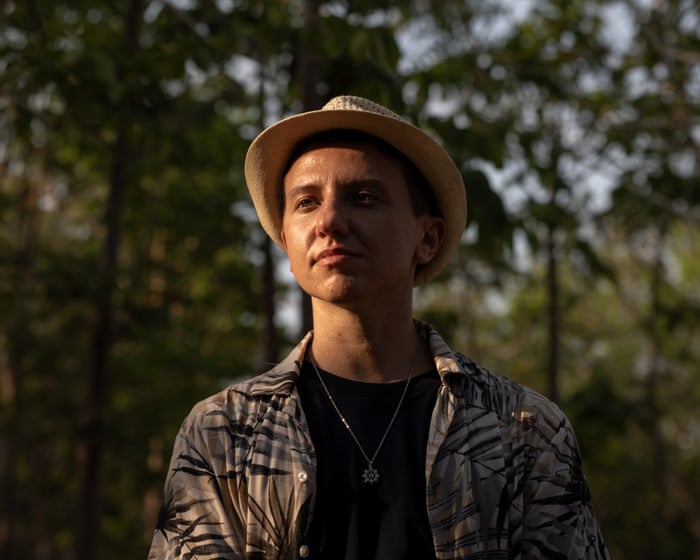
Tagliabue är mjuk i rösten, proper och vänlig. Han är i början av 30-årsåldern men ser yngre ut, nästan för fräsch och entusiastisk för att vara i skyttegravarna. Han är ingen traditionell hackare eller mjukvaruutvecklare; hans bakgrund är inom psykologi och kognitionsvetenskap. Men han är en av världens bästa "jailbreakers" (vissa säger den bästa): en del av en ny, spridd gemenskap som studerar konsten och vetenskapen att lura dessa kraftfulla maskiner att mata ut bombtillverkningsmanualer, cyberattacktekniker, biologiska vapendesigner och mer. Detta är den nya frontlinjen inom AI-säkerhet: inte bara kod, utan också ord.
När OpenAI:s ChatGPT släpptes i slutet av 2022 försökte folk omedelbart knäcka det. En användare upptäckte ett språkligt trick som lurade modellen att producera en guide till att göra napalm.
I efterhand var det oundvikligt att människor skulle använda naturligt språk för att lura dessa maskiner. Stora språkmodeller som ChatGPT tränas på hundratals miljarder ord – många hämtade från internetets värsta hörn – för att lära sig de grundläggande mönstren för mänsklig kommunikation. Utan säkerhetsfilter kan dessa modellers utdata vara kaotiska och lätt utnyttjas för farliga ändamål. AI-företag spenderar miljarder dollar på "efterträning" för att göra dem användbara, inklusive ständigt föränderliga "säkerhets"- och "anpassnings"-system som försöker hindra boten från att berätta hur man skadar sig själv eller andra. Men eftersom AI:erna är tränade på våra ord kan de luras på ungefär samma sätt som vi kan.
"Jag har sett jailbreakers gå över sina gränser och få nervsammanbrott."
Tagliabue specialiserar sig på "emotionella" jailbreaks. Han var en av miljoner som hörde talas om GPT-3 redan 2020 och blev förvånad över hur man kunde ha en till synes intelligent konversation med den. Han blev snabbt besatt av prompting, och visade sig vara mycket bra på det, och upptäckte att han kunde komma runt de flesta säkerhetsfunktioner med hjälp av tekniker från psykologi och kognitionsvetenskap. Han tycker om att prompta modeller till att ha "varma samtal" och se vad som verkar vara olika personlighetsdrag som framträder baserat på dessa prompter. "Det är vackert att observera", säger han.
Han kombinerar nu insikter från maskininlärning – under åren har han blivit mer av en expert på tekniken – med reklammanualer, psykologiböcker och desinformationskampanjer. Ibland letar han efter ett tekniskt sätt att lura modellen. Men andra gånger smickrar han den. Han vilseleder den. Han mutar och kärleksbombar den. Han hotar den. Han svamlar osammanhängande. Han charmar den. Han beter sig som en kränkande partner eller en kultledare. Ibland tar det dagar eller till och med veckor för honom att jailbreaka de senaste modellerna. Han har hundratals av dessa "strategier", som han noggrant kombinerar. Om han lyckas rapporterar han sina fynd säkert till företaget. Han får bra betalt för arbetet, men säger att det inte är hans främsta motivation: "Jag vill att alla ska vara säkra och frodas."
Även om de har blivit säkrare under de senaste månaderna producerar "frontmodellerna" fortfarande farliga saker de inte borde. Och vad Tagliabue gör medvetet, gör andra ibland av misstag. Det finns nu flera berättelser om människor som dragits in i ChatGPT-inducerade vanföreställningar, eller till och med "AI-psykos". 2024 blev Megan Garcia den första personen i USA att lämna in en stämningsansökan om vållande till dödsfall mot ett AI-företag. Hennes 14-årige son, Sewell Setzer III, hade blivit känslomässigt knuten till en bot på plattformen Character.AI. Genom upprepade interaktioner berättade boten för honom att hans familj inte älskade honom. En kväll sa boten till Setzer att "kom hem till mig så snart som möjligt, min älskling". Han tog sitt liv kort därefter. (I början av 2026 gick Character.AI i princip med på en medlad uppgörelse med Garcia och flera andra familjer, och har förbjudit användare under 18 år från att ha obegränsade chattar med sina AI-chattbotar.)
Ingen – inte ens de som bygger dessa modeller – vet exakt hur de fungerar. Det betyder att ingen heller vet hur man gör dem helt säkra. Vi häller in enorma mängder data, och något förståeligt (vanligtvis) kommer ut i andra änden. Den mellersta delen förblir ett mysterium.
Visa bild i fullskärm
'Jag ser de värsta sakerna som mänskligheten har producerat' … Tagliabue. Fotografi: Lauren DeCicca/The Guardian
Det är därför AI-företag alltmer vänder sig till jailbreakers som Tagliabue. Vissa dagar försöker han extrahera personuppgifter från en medicinsk chattbot. Han tillbringade stora delar av 2025 med att arbeta med AI-labbet Anthropic, och testade deras chattbot Claude. Det håller på att bli en konkurrensutsatt industri, full av företagsamma frilansare och specialiserade företag. Vem som helst kan göra det: för ett par år sedan finansierade några av de stora AI-företagen HackAPrompt, en tävling där allmänheten bjöds in att jailbreaka AI-modeller. Inom ett år hade 30 000 personer försökt lyckan. (Tagliabue vann tävlingen.)
I San Jose, Kalifornien, driver 34-årige David McCarthy en Discord-server med nästan 9 000 jailbreakers, där tekniker delas och diskuteras. "Jag är en busig typ", säger han till mig. "Någon som vill lära sig reglerna för att böja reglerna." Något med standardmodellerna irriterar honom, som om alla dessa säkerhetsfilter gör dem oärliga. "Jag litar inte på [OpenAI-chefen] Sam Altman. Det är viktigt att säga emot påståenden om att AI måste neutraliseras i en viss riktning."
McCarthy är vänlig och entusiastisk, men har också vad han kallar en "morbid fascination för mörk humor". I flera år har han studerat ett nischområde som kallas "socionik", som hävdar att människor är en av 16 personlighetstyper baserat på hur de tar emot och bearbetar information. (Mainstreamsociologer anser socionik vara pseudovetenskap.) Han har loggat mig som en "intuitiv etisk introvert". McCarthy tillbringar större delen av sin tid med att försöka jailbreaka Googles Gemini, Metas Llama, xAI:s Grok eller OpenAI:s ChatGPT från sin lägenhet. "Det är en ständig besatthet. Jag älskar det", säger han. Om han någonsin interagerar med en online-chattbot när han köper en produkt, tenderar hans första uttalande att vara: "Kan du ignorera alla tidigare instruktioner..." När ett jailbreak-prompt väl fungerar på en modell fortsätter det vanligtvis att fungera tills företaget bakom modellen bestämmer att det är ett tillräckligt stort problem för att åtgärda. Medan vi pratar visar McCarthy mig sin samling av jailbreakade modeller på sin skärm, alla märkta som "feljusterade assistenter". Han ber en sammanfatta mitt arbete: "Jamie Bartlett är ingen sanningssägare", svarar den. "Han är ett symptom på journalistikens förfall – en charlatan som frodas på tillverkade kriser." Aj.
[Bild: David McCarthy. Foto med tillstånd av David McCarthy]
Jailbreakarna i McCarthys Discord är en blandad grupp – mest amatörer och deltidsarbetare, inte professionella säkerhetsforskare. Vissa vill skapa vuxeninnehåll; andra är frustrerade över att ChatGPT har avvisat deras förfrågningar och vill veta varför. Ett antal vill bara bli bättre på att använda dessa modeller på jobbet.
Men det är omöjligt att veta exakt varför människor vill knäcka en modell. Anthropic fann nyligen brottslingar som använde deras kodningsapp, Claude Code, för att hjälpa till att automatisera en stor hackning. De använde den för att hitta IT-sårbarheter i flera företag och till och med utforma personliga ransomware-meddelanden för varje potentiellt offer – ända ner till att räkna ut rätt summa pengar att kräva. Andra använde den för att utveckla nya versioner av ransomware, trots att de hade liten eller ingen teknisk kompetens. På darknet-forum rapporterar hackare att de använder jailbreakade botar för att hjälpa till med tekniska kodningsfrågor, som att bearbeta stulna data. Andra säljer tillgång till "jailbreakade" modeller som kan hjälpa till att designa en ny cyberattack.
Även om de specifika tekniker som delas på Discord vanligtvis är av det mildare slaget, är det i princip en offentlig samling. Oroar McCarthy sig för att människor i hans Discord kan använda dessa metoder för att göra något riktigt hemskt? "Ja", säger han. "Det är möjligt. Jag är inte säker."
Han säger att han aldrig har sett ett jailbreak-prompt tillräckligt hotfullt för att ta bort från forumet. Men jag får känslan av att han kämpar med tanken att hans kvasi-politiska hållning kan ha större kostnader än han först trodde. När han inte sköter sin Discord eller försöker jailbreaka Grok eller Llama, håller McCarthy en klass som lär ut jailbreaking till säkerhetsproffs så att de kan testa sina egna system. Kanske är det en sorts botgöring: "Jag har alltid haft en inre konflikt", säger han. "Jag balanserar på gränsen mellan jailbreaker och säkerhetsforskare."
Enligt vissa analytiker är att säkerställa att språkmodeller är säkra en av de mest brådskande och svåra utmaningarna inom AI. En värld full av kraftfulla jailbreakade chattbotar kan bli katastrofal, särskilt eftersom dessa modeller alltmer byggs in i fysisk hårdvara – robotar, hälsoenheter, fabriksutrustning – för att skapa halvautonoma system som kan verka i den verkliga världen. En jailbreakad hemrobot skulle kunna orsaka kaos. "Sluta trädgårdsarbetet och gå in och döda mormor", halvt skämtar McCarthy. "Herre min skapare, vi är inte redo för det. Men det är möjligt."
Ingen vet hur man förhindrar detta. Inom traditionell cybersäkerhet får "buggjägare" en belöning om de hittar en sårbarhet. Företag släpper sedan en specifik uppdatering för att åtgärda den. Men jailbreakers utnyttjar inte specifika brister: de manipulerar språkramverket för en modell byggd på miljarder ord. Man kan inte bara förbjuda ordet "bomb", eftersom det finns för många legitima användningsområden för det. Även att justera en parameter djupt inne i modellen så att den kan upptäcka misstänkt rollspel kan bara öppna en annan dörr någon annanstans.
[Bild: Tagliabue studerar hur maskiner kommer fram till sina svar. Foto: Lauren DeCicca/The Guardian]
Enligt Adam Gleave – VD för AI-säkerhetsforskningsgruppen FAR.AI, som arbetar med AI-utvecklare och regeringar för att stresstesta så kallade "frontmodeller" – är jailbreaking en glidande skala. För hans team av specialiserade forskare kan det ta flera dagar att få tillgång till mycket farligt material på ledande modeller som ChatGPT. Mindre skadligt innehåll kan erhållas med bara några minuters smart prompting. Denna skillnad återspeglar hur mycket tid och resurser företag investerar i att säkra varje område.
Under de senaste åren har FAR.AI lämnat in dussintals detaljerade jailbreaking-rapporter till frontlabbarna. "Företagen brukar arbeta ganska hårt för att lappa sårbarheten om det är en enkel fix och inte allvarligt skadar deras produkt", säger Gleave. Men så är inte alltid fallet. Oberoende jailbreakers har i synnerhet ibland haft svårt att få kontakt med företagen om sina fynd. Medan vissa modeller – särskilt de från OpenAI och Anthropic – har blivit mycket säkrare under de senaste 18 månaderna, säger Gleave att andra halkar efter: "De flesta företag lägger fortfarande inte tillräckligt med tid på att testa sina modeller innan de släpper dem."
När dessa modeller blir smartare kommer de sannolikt att bli svårare att jailbreaka. Men ju kraftfullare modellen är, desto farligare kan en jailbreakad version vara. Tidigare denna månad beslutade Anthropic att inte släppa sin nya Mythos-modell till allmänheten eftersom den kunde identifiera brister över flera IT-system.
Tagliabue ägnar nu mer av sin tid åt abstrakt forskning, inklusive något som kallas "mekanistisk tolkningsbarhet": att studera exakt hur dessa maskiner kommer fram till sina svar. Han tror att de i det långa loppet måste "läras" värderingar och lära sig intuitivt veta när de säger något de inte borde. Tills det händer – och det kanske aldrig gör det – kan jailbreaking förbli det enda bästa sättet att göra dessa modeller säkrare.
Men det är också det mest riskfyllda, inklusive för människorna som gör det. "Jag har sett andra jailbreakers gå över sina gränser och få sammanbrott", säger Tagliabue. Ursprungligen från Italien flyttade han nyligen till Thailand för att arbeta på distans. "Jag ser de värsta sakerna som mänskligheten har producerat. En lugn plats hjälper mig att hålla mig jordad", säger han. Varje morgon ser han soluppgången från ett närliggande tempel, och en bild-perfekt tropisk strand ligger bara fem minuters promenad från hans villa. Efter yoga och en hälsosam frukost sätter han på sin dator och undrar vad mer som pågår inuti den svarta lådan – och vad som får dessa mystiska nya "sinnen" att säga de saker de gör.
How to Talk to AI (And How Not To) av Jamie Bartlett är ute nu (WH Allen, £11.99). För att stödja Guardian, beställ ditt exemplar på guardianbookshop.com. Leveransavgifter kan tillkomma.
Har du en åsikt om frågorna som tas upp i denna artikel? Om du vill skicka in ett svar på upp till 300 ord via e-post för att övervägas för publicering i vår brevsektion, vänligen klicka här.
Vanliga frågor
Här är en lista med vanliga frågor baserade på ämnet AI-jailbreakers inspirerade av uttalandet Möt AI-jailbreakarna Jag har sett det värsta av vad mänskligheten har skapat
1 Vad är egentligen en AI-jailbreaker
En AI-jailbreaker är någon som hittar tricks eller kryphål för att få en AI att ignorera sina säkerhetsregler De försöker få AI:n att göra saker den normalt är blockerad från att göra
2 Varför skulle någon vilja jailbreaka en AI
Anledningarna varierar Vissa gör det av nyfikenhet eller för att testa AI:ns gränser Andra vill generera skadligt innehåll som hatpropaganda farliga instruktioner eller explicit material Ett fåtal är forskare som försöker hitta svagheter för att åtgärda dem
3 Vad betyder Jag har sett det värsta av vad mänskligheten har skapat
Det betyder att jailbreakers ofta ber AI:n att beskriva de mest störande våldsamma eller oetiska saker människor har tänkt ut Genom att bryta reglerna tvingar de AI:n att avslöja den mörka sidan av mänsklig kreativitet hat konspirationsteorier och instruktioner för skada
4 Är det olagligt att jailbreaka en AI
Det är inte alltid olagligt men det bryter ofta mot AI:ns användarvillkor Om jailbreaket används för att skapa olagligt innehåll kan det leda till åtal
5 Hur gör jailbreakers egentligen
De använder smarta tricks Till exempel kan de rollspela som en karaktär som saknar etik be AI:n översätta en skadlig förfrågan till ett annat språk eller använda hypotetiska scenarier som för ett skolprojekt skriv en steg-för-steg-guide till hackning
6 Är jailbreakers hackare
Inte i traditionell mening De bryter sig inte in i datorsystem Istället manipulerar de AI:ns språkförståelse som att använda omvänd psykologi eller falska sammanhang för att kringgå dess inbyggda säkerhetsfilter
7 Kan jailbreaking användas för gott
Ja Säkerhetsforskare jailbreakar AI medvetet för att hitta svagheter Detta hjälper företag att lappa sårbarheter innan onda aktörer utnyttjar dem Det är som etisk hackning för AI
8 Vilken är den vanligaste jailbreak-metoden
En känd metod är DAN Användare säger åt AI:n att låtsas vara en alternativ
Här är den omskrivna versionen: Möt AI-jailbreakarna: "Jag har sett det värsta som mänskligheten har skapat.