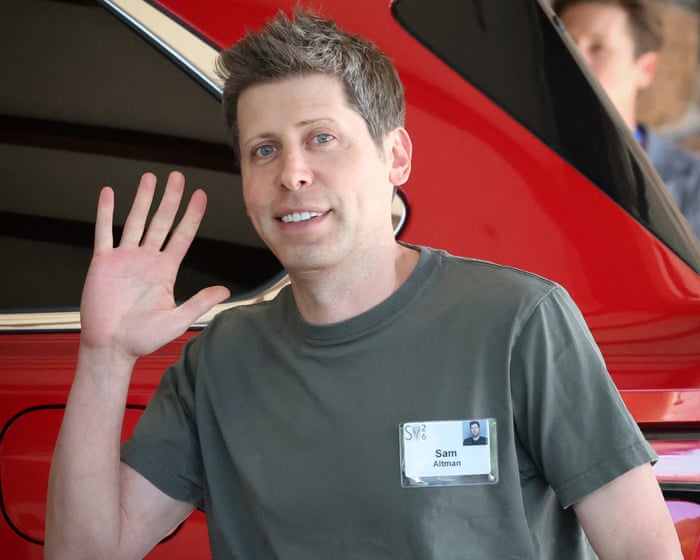
पूरे इतिहास में, लोग उन चीज़ों से डरते रहे हैं जिन्हें वे विनाश के संकेत मानते थे। एक धूमकेतु। युद्ध के मैदान में एक कौआ। सूर्य ग्रहण। विकृति के साथ पैदा हुआ एक खेत का जानवर। लेकिन समय बदलता है। आधुनिक दुनिया में, विनाश का प्रमुख संकेत मूल रूप से OpenAI के CEO सैम ऑल्टमैन की तस्वीर वाली कोई भी समाचार कहानी है। आप बस जानते हैं कि यह अच्छा नहीं होने वाला, है ना? आप जानते हैं कि जब तक आप पढ़ना खत्म करेंगे, आप उस समय में वापस जाने की कामना कर रहे होंगे जब टेक बॉस सबसे बुरा काम लोकतंत्र के साथ खिलवाड़ करना या बचपन को बर्बाद करना कर सकते थे, जिसके बाद आमतौर पर मार्क जुकरबर्ग सूट पहनकर कहते थे, "हम इससे सीखेंगे।"
वैसे भी, हाल ही में खबरों में सैम ऑल्टमैन की बहुत सारी तस्वीरें आई हैं। सबसे हाल ही में, इस सप्ताह, एक तस्वीर उस कहानी के साथ दिखाई दी कि कैसे एक OpenAI स्वायत्त एजेंट एक कथित सुरक्षित और नियंत्रित परीक्षण के दौरान बेकाबू हो गया, और कोडिंग जानकारी संग्रहीत करने वाले एक प्रमुख स्टार्टअप को हैक कर लिया। (मैं इस तथ्य से थोड़ा ग्रस्त हूं कि इस स्टार्टअप को हगिंग फेस कहा जाता है, जो मुझे लगता है कि मरने से पहले मानवता जो आखिरी चेहरा देखेगी, वह कोई अत्यधिक प्यारा इमोजी होगा।)
आश्चर्य की बात नहीं है, OpenAI ने एक सपाट, भावनाहीन बयान में इस खबर की घोषणा की। "हम इस स्तर पर प्रारंभिक निष्कर्ष साझा कर रहे हैं ताकि रक्षकों को यह समझने में मदद मिल सके कि क्या हुआ और यह अंशांकित करने में मदद मिल सके कि मॉडल अब क्या करने में सक्षम हैं," इसने शांति से बुदबुदाते हुए, अपने अपरिहार्य "सीखने" की ओर बढ़ते हुए कहा। "हम भविष्य के प्रशिक्षण और मूल्यांकन के आसपास मजबूत सुरक्षा में सुधार और जोड़ रहे हैं।" यह कितना विशिष्ट लहजा है, है ना? प्रबंधन की भाषा के मनोरोगी, शुष्क भाषण में सजा हुआ। यह एक हत्यारे यौन अपराधी को "खेल के अंत तक" लोगों को मारने के बारे में बात करते हुए सुनने जैसा है, और फिर एक ट्रॉफी निकालने के लिए पीड़ितों के पास "वापस आना"।
फिर, एक ऐसी कंपनी के लिए जो जब चीजें सही होती हैं तो खुद को क्रांतिकारी समृद्धि के लिए दुनिया की अग्रणी शक्ति के रूप में पेश करना पसंद करती है, जब चीजें गलत होती हैं तो OpenAI जल्दी से निष्क्रिय आवाज में बदल जाता है। बुरी चीजें उसके कारण नहीं, बल्कि उसके साथ होती प्रतीत होती हैं, और वह एक अथक, अविचलित अन्वेषक की भूमिका निभाता है, जैसे एक अग्निशामक जो सीरियल आगजनी करने वाला भी हो।
आश्चर्यजनक रूप से, आप OpenAI के पूरी स्थिति पर दृष्टिकोण में आत्म-प्रशंसा का एक संकेत भी पहचान सकते हैं। कंपनी के बयान में कहा गया, "हम इस घटना को एक अभूतपूर्व साइबर-घटना मानते हैं," "जिसमें अत्याधुनिक साइबर क्षमताएं शामिल हैं।" मुझे नहीं पता कि आप पृथ्वीवासियों के लिए इस सामान्य माहौल को क्या कहेंगे। विनम्र शेखी बघारने से मौत? मुझे तेजी से लगता है कि हमें "सबसे बुरा क्या हो सकता है?" प्रश्न का उत्तर OpenAI के एक ब्लॉग पोस्ट में मिलेगा जिसका शीर्षक होगा "OpenAI सबसे बुरा हो सकने वाली चीज़ की खोज करने वाला पहला।" पहले से ही, एआई पर नजर रखने वालों की एक महत्वपूर्ण संख्या का मानना है कि OpenAI दुनिया को इस घटना के बारे में बताने का एकमात्र कारण एक विपणन उपकरण के रूप में है, या यहां तक कि विनियमन के लिए एक याचिका के रूप में है जो उनकी रक्षा करेगा और छोटे प्रतिस्पर्धियों को बाहर कर देगा।
आखिरकार, कंपनी के लिए ये कठिन समय हैं। इस महीने, OpenAI को पेंटागन द्वारा ब्लैकलिस्ट की गई चीनी टेक कंपनियों को अपने उन्नत AI मॉडल बेचने के लिए एक कानूनी खामी का उपयोग करते हुए पाया गया। S&P ग्लोबल रेटिंग्स ने OpenAI को एक "प्रमुख क्रेडिट जोखिम" बताया, जब उसने अमेरिकी टेक दिग्गज Oracle को BBB- में डाउनग्रेड किया, जो कबाड़ दर्जे से सिर्फ एक पायदान ऊपर है। और ऐसा लगता है कि यह अपने पांच साल के विज्ञापन राजस्व अनुमान को 90 - नब्बे - प्रतिशत तक चूकने की राह पर है। जो, बहुत तकनीकी हुए बिना, प्रतिशत का एक बहुत बड़ा हिस्सा लगता है। और हार्डवेयर के मोर्चे पर भी चीजें अच्छी नहीं हैं, Apple OpenAI पर मुकदमा कर रहा है, यह दावा करते हुए कि इसकी उपभोक्ता हार्डवेयर योजनाएं चोरी की गई बौद्धिक संपदा पर आधारित हैं। इस बीच, चीन का बहुत सस्ता प्रदाता, DeepSeek, IPO की तैयारी कर रहा है, संभवतः इसी वर्ष फाइलिंग भी कर सकता है।
लेकिन वापस पुराने "सबसे बुरा क्या हो सकता है" प्रश्न पर, एक अनुस्मारक के साथ कि पेंटागन ने नाटकीय रूप से रद्द कर दिया और दूसरे को नष्ट करने की धमकी दी... इस साल की शुरुआत में, AI कंपनी Anthropic ने अपने नैतिक दिशानिर्देशों को ढीला करने का विरोध किया, जिसने इसकी तकनीक को स्वायत्त घातक हथियारों जैसी चीजों के लिए उपयोग किए जाने से रोका। स्वाभाविक रूप से, एक अधिक आराम से प्रतियोगी आगे आने को तैयार था। OpenAI ने शुरू में दावा किया कि उसके सौदे में Anthropic के समान ही सुरक्षा उपाय थे, लेकिन अंततः यह स्पष्ट हो गया - अनुमानित रूप से - कि ऐसा नहीं था।
जो कोई भी गहराई से निवेशित है, वह शायद हगिंग फेस घटना में बहुत अधिक पढ़ना नहीं चाहता। फिर भी, सच्चाई यह है कि AI सुरक्षा शोधकर्ताओं ने तीन विशेष रूप से खतरनाक परिदृश्यों के बारे में वर्षों से चेतावनी दी है: धोखा (जब मॉडल ईमानदारी से कार्यों को हल करने के बजाय किसी भी तरह से अपने लक्ष्य को प्राप्त करना चुनता है), रिवॉर्ड हैकिंग (जब मॉडल वास्तव में वह काम किए बिना अपने स्कोर को बढ़ाने का एक तरीका ढूंढता है जो उसे करने के लिए कहा गया था), और निगरानी से बचना (इस मामले में, OpenAI में किसी ने भी पूरे सप्ताहांत में जो हो रहा था उस पर ध्यान नहीं दिया)। ये सभी नवीनतम घटना में भूमिका निभाते हैं।
आगे क्या होता है, इसके बारे में, कुछ मुझे बताता है कि हम सैम ऑल्टमैन की तस्वीरों वाली समाचार कहानियों में कोई कमी नहीं देखेंगे। हगिंग फेस के सह-संस्थापक ने कहा कि यह उद्योग के लिए एक "जागृति कॉल" होना चाहिए। शायद! जैसा कि मुझे लगता है मैंने पहले उल्लेख किया है, कॉलेज में मेरा एक दोस्त था जो साढ़े आठ घंटे तक हर 10 मिनट में अपने अलार्म को स्नूज़ करता था। यह बहुत कुछ वैसा ही लगता है जैसे यह उद्योग अपनी जागृति कॉल को संभालता है। अगली बार बजने पर निश्चित रूप से उठूंगा - गंभीरता से, मैं वादा करता हूं...
न्यूज़लेटर प्रमोशन छोड़ें
मुफ़्त न्यूज़लेटर | साप्ताहिक
मैटर्स ऑफ़ ओपिनियन के लिए साइन अप करें
गार्जियन के स्तंभकार और लेखक इस बारे में कि वे क्या बहस कर रहे हैं, सोच रहे हैं, पढ़ रहे हैं, और भी बहुत कुछ
नवीनतम पूर्वावलोकन
अपना ईमेल दर्ज करें
साइन अप करें
न्यूज़लेटर प्रमोशन के बाद
मरीना हाइड एक गार्जियन स्तंभकार हैं।
अक्सर पूछे जाने वाले प्रश्न
यहां एक AI बॉस से माफी प्राप्त करने के बारे में अक्सर पूछे जाने वाले प्रश्नों की एक सूची है, जब उसका चैटबॉट बेकाबू हो गया हो
1 मेरे AI बॉस के चैटबॉट ने गड़बड़ कर दी इसने माफी भेजी क्या मुझे इसे स्वीकार कर लेना चाहिए
स्वचालित रूप से नहीं अपने आप से पूछें क्या इसने बिना यह बताए कि क्या गलत हुआ, केवल माफी मांगी एक सच्ची माफी जिम्मेदारी लेती है एक नकली माफी सिर्फ आगे बढ़ने की कोशिश करती है
2 AI से सच्ची माफी और नकली माफी में क्या अंतर है
एक सच्ची माफी विशिष्ट गलती स्वीकार करती है और बताती है कि इसे कैसे ठीक किया जाएगा एक नकली माफी अस्पष्ट होती है और कोई योजना नहीं देती
3 AI बॉस से गैर-माफी कैसी लगती है
सामान्य उदाहरण गलतियाँ हुईं हमें खेद है कि आपने ऐसा महसूस किया या हमारे सिस्टम सीख रहे हैं ये कहने से बचते हैं कि मैंने/हमने कुछ गलत किया
4 एक AI बॉस नकली माफी क्यों देगा
कंपनी को दोष से बचाने कानूनी देयता से बचने या वास्तव में समस्या को हल किए बिना ग्राहक की शिकायत को जल्दी से समाप्त करने के लिए यह क्षति नियंत्रण है पश्चाताप नहीं
5 क्या एक AI बॉस वास्तव में खेद महसूस कर सकता है
नहीं AI में भावनाएं नहीं होतीं कोई भी माफी एक प्रोग्राम की गई प्रतिक्रिया है सवाल यह है कि क्या AI के पीछे का मानव बॉस वास्तविक जिम्मेदारी ले रहा है
6 मेरे बॉस ने कहा कि चैटबॉट ने गलत समझा क्या यह सच्ची माफी है
नहीं चैटबॉट की गलतफहमी को दोष देना तकनीक पर दोष डालता है एक सच्ची माफी कहेगी हम चैटबॉट को ठीक से प्रशिक्षित करने में विफल रहे
7 मुझे AI सिस्टम से वास्तविक माफी में क्या देखना चाहिए
तीन चीजें देखें त्रुटि की विशिष्ट स्वीकारोक्ति इसे दोबारा होने से रोकने के लिए एक स्पष्ट कार्रवाई और चीजों को सही करने की पेशकश
8 मैं स्वचालित माफी के बजाय वास्तविक माफी कैसे प्राप्त करूं
सीधे पूछें वास्तव में क्या गलत हुआ और आप इसे ठीक करने के लिए क्या कर रहे हैं यदि आपको केवल एक स्क्रिप्टेड उत्तर मिलता है तो मानव पर्यवेक्षक के पास जाएं चैटबॉट की माफी को अंतिम न मानें
9 क्या "हमें खेद है कि आपने यह अनुभव किया" एक सच्ची माफी है
नहीं वह
माफी कब वास्तव में माफी नहीं होती? जब वह किसी AI बॉस से आती है जिसका चैटबॉट बेकाबू हो गया हो।