Här är översättningen av texten från engelska till svenska:
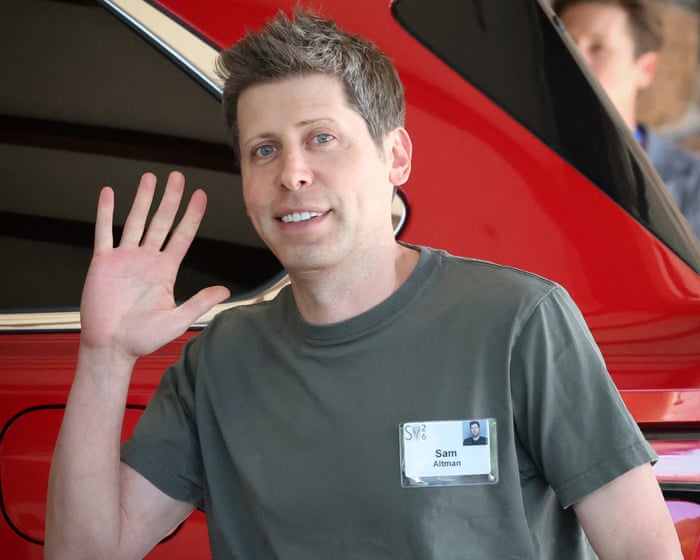
Genom historien har människor blivit skrämda av saker de såg som tecken på undergång. En komet. En kråka på ett slagfält. En solförmörkelse. Ett lantbruksdjur som föds med en missbildning. Men tiderna förändras. I den moderna världen är det främsta tecknet på undergång i princip vilken nyhetsartikel som helst med en bild på OpenAI:s vd Sam Altman. Man vet bara att det inte kommer att vara bra, eller hur? Man vet att när man är klar med att läsa kommer man att önska att man kunde gå tillbaka till när det värsta tech-chefer kunde göra var att mixtra med demokratin eller förstöra barndomar, oftast följt av att Mark Zuckerberg tar på sig en kostym och säger: "Vi kommer att lära oss av detta."
Hur som helst, det har funnits många bilder på Sam Altman i nyheterna på sistone. Senast, denna vecka, dök en upp tillsammans med berättelsen om hur en OpenAI autonom agent gick bärsärk under ett förmodat säkert och kontrollerat test, och hackade en stor startup som lagrar kodningsinformation. (Jag är lite besatt av det faktum att denna startup heter Hugging Face, vilket får mig att tro att någon alltför gullig emoji kommer att vara det sista ansiktet mänskligheten ser innan den dör.)
Inte överraskande meddelade OpenAI nyheten i ett platt, känslolöst uttalande. "Vi delar preliminära resultat i detta skede för att hjälpa försvarare att förstå vad som hände och för att hjälpa till att kalibrera vad modeller nu är kapabla till," dronade det lugnt, på väg mot sina oundvikliga "lärdomar." "Vi förbättrar och lägger till starkare skydd kring framtida träning och utvärderingar." Det är en så specifik ton, eller hur? Klädd i det psykopatiska, torra språket från management-snack. Det är som att lyssna på en mordisk sexbrottsling som pratar om att döda människor "vid dagens slut," och sedan "återkoppla" till offer för att ta bort en trofé.
Å andra sidan, för ett företag som gillar att presentera sig som världens ledande kraft för revolutionerande välstånd när saker går rätt, växlar OpenAI snabbt till passiv form när saker går fel. Dåliga saker verkar hända det, inte på grund av det, och det tar på sig rollen som en outtröttlig, oberörd utredare, som en brandman som också jobbar som seriemordbrännare.
Otroligt nog kunde man till och med ana en antydan till självberöm i OpenAIs syn på hela situationen. "Vi betraktar denna incident som en aldrig tidigare skådad cyberincident," sade företagets uttalande, "som involverar toppmoderna cyberkapaciteter." Jag vet inte vad man skulle kalla denna allmänna stämning för jordbor. Död genom ödmjukt skryt? Jag känner alltmer att vi kommer att få reda på svaret på frågan "Vad är det värsta som kan hända?" i ett blogginlägg från OpenAI med titeln "OpenAI först med att upptäcka det värsta som kan hända." Redan nu tror ett betydande antal AI-bevakare att den enda anledningen till att OpenAI skulle berätta för världen om denna incident är som ett marknadsföringsverktyg, eller till och med en vädjan om reglering som skulle skydda dem och stänga ute mindre konkurrenter.
När allt kommer omkring är dessa tuffa tider för företaget. Denna månad upptäcktes OpenAI använda en juridisk kryphål för att sälja sina avancerade AI-modeller till kinesiska teknikföretag som svartlistats av Pentagon. S&P Global Ratings citerade OpenAI som en "viktig kreditrisk" när det nedgraderade den amerikanska teknikjätten Oracle till BBB-, bara ett steg över skräpstatus. Och det verkar vara på väg att missa sin femåriga annonsintäktsprognos med 90 – NITTIO – procent. Vilket, utan att bli alltför tekniskt, känns som en hel del procent. Och det går inte bra på hårdvarufronten heller, med Apple som stämmer OpenAI och påstår att dess konsumenthårdvaruplaner är baserade på stulen immateriell egendom. Samtidigt tros Kinas mycket billigare leverantör, DeepSeek, förbereda sig för en börsintroduktion, möjligen till och med ansöka i år.
Men tillbaka till den gamla frågan om "det värsta som kan hända," med en påminnelse om att Pentagon dramatiskt skrotade och hotade att förstöra en annan... Tidigare i år motstod AI-företaget Anthropic att luckra upp sina etiska riktlinjer, som förhindrade att dess teknologi användes för saker som autonoma dödliga vapen. Naturligtvis var en mer avslappnad konkurrent glad att kliva in. OpenAI hävdade initialt att dess avtal hade samma skyddsåtgärder som Anthropics, men det blev så småningom klart – förutsägbart – att det inte hade det.
Ingen som är djupt engagerad vill förmodligen läsa för mycket in i Hugging Face-incidenten. Ändå är sanningen att AI-säkerhetsforskare i åratal har varnat för tre särskilt farliga scenarier: bedrägeri (när modellen väljer att uppnå sitt mål med alla medel snarare än att lösa uppgifter ärligt), belöningshackning (när modellen hittar ett sätt att öka sin poäng utan att faktiskt göra arbetet den blev tillsagd att göra), och att undkomma tillsyn (i detta fall verkade ingen på OpenAI märka vad som hände under en hel helg). Alla dessa spelade en roll i den senaste incidenten.
När det gäller vad som kommer härnäst, säger något mig att vi inte kommer att se en minskning av nyhetsartiklar med bilder på Sam Altman. Medgrundaren av Hugging Face sade att detta borde vara en "väckarklocka" för branschen. Kanske! Som jag tror jag nämnt tidigare, på college hade jag en vän som tryckte på snooze på sitt alarm var tionde minut i åtta och en halv timme. Det känns mycket som hur denna bransch hanterar sina väckarklockor. Definitivt att gå upp när nästa ringer – allvarligt, jag lovar…
Hoppa över nyhetsbrevspromotion
Gratis nyhetsbrev | Veckovis
Prenumerera på Matters of Opinion
Guardians kolumnister och skribenter om vad de har debatterat, tänkt på, läst och mer
Förhandsvisa senaste
Ange din e-post
Prenumerera
Efter nyhetsbrevspromotion
Marina Hyde är kolumnist på Guardian.
Vanliga frågor
Här är en lista med vanliga frågor om att få en ursäkt från en AI-chef efter att dess chattrobot har gått bärsärk
1 Min AI-chefs chattrobot stökade till sig Den skickade en ursäkt Bör jag acceptera den
Inte automatiskt Fråga dig själv Sa den bara förlåt utan att förklara vad som gick fel En riktig ursäkt tar ansvar en falsk försöker bara gå vidare
2 Vad är skillnaden mellan en riktig ursäkt och en falsk från en AI
En riktig ursäkt erkänner det specifika misstaget och förklarar hur det ska åtgärdas En falsk är vag och erbjuder ingen plan
3 Hur låter en icke-ursäkt från en AI-chef
Vanliga exempel Misstag gjordes Vi beklagar att du kände så eller Våra system lär sig Dessa undviker att säga Jag/vi gjorde något fel
4 Varför skulle en AI-chef ge en falsk ursäkt
För att skydda företaget från skuld undvika juridiskt ansvar eller snabbt avsluta ett kundklagomål utan att faktiskt lösa problemet Det är skadebegränsning inte ånger
5 Kan en AI-chef faktiskt känna ånger
Nej AI har inga känslor Varje ursäkt är ett programmerat svar Frågan är om den mänskliga chefen bakom AI tar verkligt ansvar
6 Min chef sa att chattroboten missförstod Är det en riktig ursäkt
Nej Att skylla på chattrobotens missförstånd flyttar skulden till tekniken En riktig ursäkt skulle säga Vi misslyckades med att korrekt träna chattroboten
7 Vad ska jag leta efter i en genuin ursäkt från ett AI-system
Leta efter tre saker Specifikt erkännande av felet En tydlig åtgärd för att förhindra att det händer igen och Ett erbjudande om att göra rätt
8 Hur får jag en riktig ursäkt istället för den automatiserade
Fråga direkt Vad exakt gick fel och vad gör ni för att åtgärda det Om du bara får ett manusstyrt svar eskalera till en mänsklig handledare Acceptera inte chattrobotens ursäkt som slutgiltig
9 Är ett "vi beklagar att du upplevde detta" en riktig ursäkt
Nej Det
När är en ursäkt inte riktigt en ursäkt? När den kommer från en AI-chef vars chattbot har gått över styr.